Welk AI-model draai je op je eigen laptop? Gemeten op 16 GB, oktober 2026
Welk AI-model draai je lokaal op een gewone laptop met 16 GB? Qwen3.5 en Gemma 4 vergeleken, met zelf gemeten snelheden, een stappenplan voor Ollama, voorbeelden om mee te beginnen en de twee instellingen die het meeste verschil maken.

Ik vroeg een AI-model op mijn laptop hoeveel dagen er tussen 1 maart en 1 juni zitten. Na 94 seconden kwam het antwoord: 92. Daarna stelde ik dezelfde vraag aan hetzelfde model op dezelfde laptop, met één instelling anders. Toen kwam hetzelfde antwoord na 3,5 seconden.
Dat verschil zegt veel over lokale AI in 2026. Een taalmodel op je eigen laptop draaien is niet moeilijk meer: één programma installeren en één commando typen. Of het daarna prettig werkt, hangt af van een paar keuzes die bijna niemand je vertelt. Welk model past in je geheugen? Hoeveel tekst mag het tegelijk onthouden? En moet het eerst nadenken of meteen antwoorden?
Dit artikel is voor wie het een keer wil proberen. Het is geschreven voor een doorsnee laptop van nu, met 16 GB geheugen, met of zonder losse videokaart. Je leest welk model je kiest, hoe je het installeert, wat je ervan kunt verwachten en hoe je de grootste fouten voorkomt.
Feiten gecontroleerd op 9 oktober 2026. De snelheden in dit artikel heb ik zelf gemeten met Ollama 0.35.1 op mijn laptop: een Intel Core i9-13980HX met 16 GB DDR5-5600 en een Nvidia RTX 4070 Laptop met 8 GB videogeheugen. Voor de metingen zonder videokaart heb ik de gpu uitgeschakeld. Bestandsgroottes komen uit de modelbibliotheek van Ollama, overige cijfers uit de modelkaarten. Rekenvoorbeelden staan als rekenvoorbeeld aangegeven.
Welk AI-model kies je voor je laptop? Het korte antwoord
Voor de meeste laptops met 16 GB is Qwen3.5 van Alibaba in oktober 2026 de beste keuze: de 4B-versie als je laptop geen losse videokaart heeft, de 9B-versie als je er wel een hebt of een MacBook gebruikt. Beide zijn gratis, mogen ook commercieel gebruikt worden (Apache 2.0), begrijpen Nederlands en kunnen ook afbeeldingen lezen.
| Jouw laptop | Begin met | Commando | Wat je kunt verwachten |
|---|---|---|---|
| 16 GB, geen losse videokaart (de meeste Windows-laptops) | Qwen3.5 4B (3,3 GB) | ollama run qwen3.5:4b | rond de 15 tokens per seconde, goed bij te lezen |
| 16 GB met een losse gpu van 8 GB | Qwen3.5 9B (6,6 GB) | ollama run qwen3.5:9b | rond de 40 tokens per seconde, sneller dan je leest |
| MacBook met 16 GB | Qwen3.5 9B (6,6 GB) | ollama run qwen3.5:9b | niet gemeten; zie het rekenvoorbeeld verderop |
| 8 GB geheugen | Qwen3.5 2B (2,7 GB) | ollama run qwen3.5:2b | bruikbaar voor korte taken, niet meer |
Zet daarbij de denkmodus uit voor gewone vragen (--think=false, verderop meer). Wat die keuzes betekenen en waarom ze zo uitvallen, staat hieronder.
Wat "lokaal draaien" betekent
Een taalmodel is een groot bestand met getallen, de gewichten. Bij Qwen3.5 9B is dat bestand 6,6 GB. Een programma als Ollama laadt dat bestand in het geheugen van je laptop en rekent daarmee woord voor woord een antwoord uit. Er gaat niets naar een server: na de download werkt het ook zonder internet, in de trein of in het vliegtuig.
Dat heeft drie gevolgen die je meteen merkt. Een vraag kost niets, hoe vaak je hem ook stelt. Wat je typt of plakt, blijft op je laptop: Ollama schrijft in de eigen documentatie dat het bij lokale modellen je prompts en gegevens niet ziet. En je laptop doet het werk, dus de ventilator gaat draaien en de accu loopt sneller leeg.
Eén valkuil: Ollama biedt ook cloudmodellen aan. Die herken je aan cloud in de naam, zoals gemma4:cloud. Die draaien op de servers van Ollama, en je moet ervoor inloggen. Wie lokaal wil blijven, kiest een naam zonder cloud.
Waarom het geheugen bepaalt welk model past
Het getal achter een modelnaam, 4B of 9B, is het aantal parameters in miljarden ("billions"). Elke parameter is een getal dat het model tijdens de training heeft geleerd. Bij volle precisie kost elk getal 2 bytes. Qwen3.5 9B zou dan 19 GB groot zijn, en zo staat die versie ook in de bibliotheek van Ollama. Dat past niet in een laptop met 16 GB.
Daarom worden modellen voor thuisgebruik gecomprimeerd tot ongeveer 4 bits per getal. Dat heet quantiseren. De standaardversie van Qwen3.5 9B in Ollama (q4_K_M) is daardoor 6,6 GB in plaats van 19. Het model wordt er iets minder nauwkeurig van, maar het verschil is veel kleiner dan het verschil met een model dat half zo groot is. Een 9B-model in 4 bits is daarom bijna altijd een betere keuze dan een 4B-model in volle precisie.
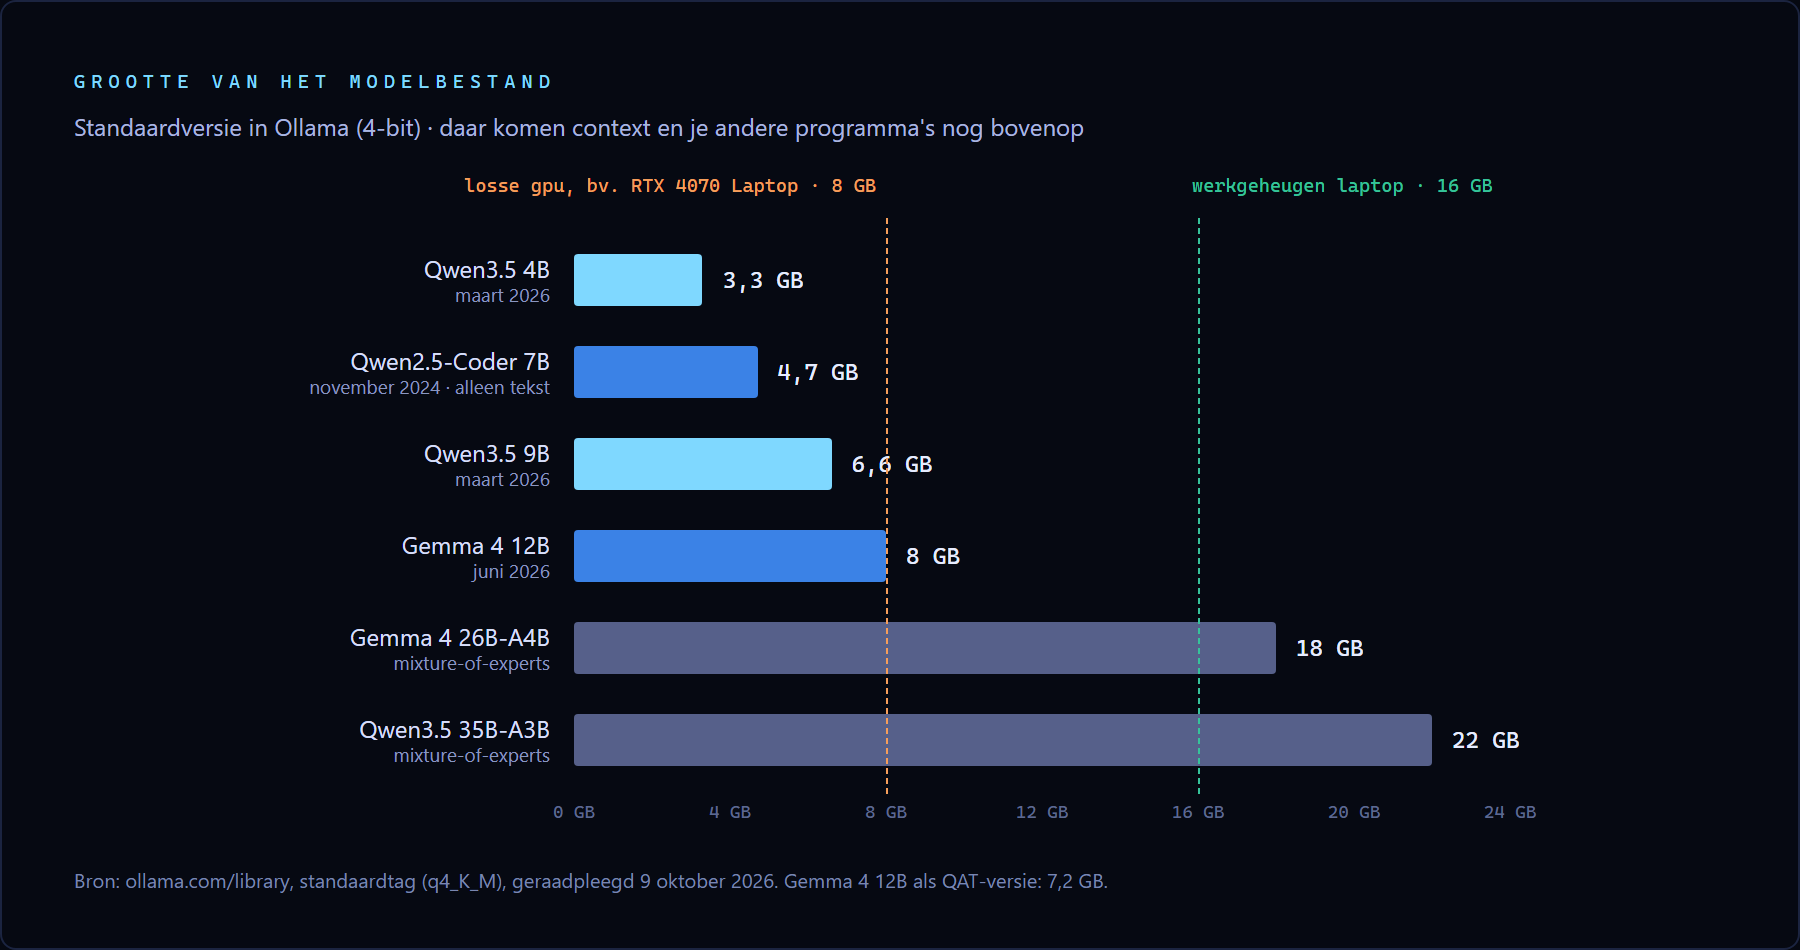
Dat het bestand past, is niet genoeg. Windows, je browser en de rest van wat openstaat, gebruiken ook geheugen. Toen ik dit schreef, stonden op mijn laptop een code-editor en een browser open, en van de 16 GB was nog 1,9 GB vrij. Laad je dan een model van 6 GB in het werkgeheugen, dan gaat Windows gegevens naar de schijf verplaatsen en wordt alles traag, niet alleen het model. Een praktische vuistregel: houd het modelbestand onder de helft van je werkgeheugen, en sluit de browser voordat je begint. In Taakbeheer (Ctrl+Shift+Esc, tabblad Prestaties) zie je hoeveel er vrij is.
Werkgeheugen, videogeheugen en de Mac: drie soorten laptops
"16 GB" zegt niet alles, want een laptop kan op drie manieren rekenen. Het verschil bepaalt meer dan welk model je kiest.
Een laptop zonder losse videokaart. Dit is de doorsnee Windows-laptop, ook de meeste Copilot+-laptops met een Intel Core Ultra, AMD Ryzen AI of Snapdragon X. Ollama rekent daar op de processor, met het model in het gewone werkgeheugen. De NPU, de AI-chip waarmee die laptops geadverteerd worden, gebruikt Ollama voor zover ik kon nagaan niet: die zet Windows in voor eigen functies, zoals Live Captions. Voor taalmodellen telt hier vooral het werkgeheugen.
Een laptop met een losse videokaart. Gamelaptops en zwaardere werklaptops hebben vaak een Nvidia-gpu met eigen videogeheugen, meestal 6 of 8 GB. Dat geheugen is veel sneller dan het werkgeheugen, maar ook kleiner. Een RTX 4070 Laptop heeft er 8 GB van. Bij mijn metingen kon Ollama daarvan ongeveer 5,5 GB voor het model gebruiken: de rest hield Windows bezet voor het beeldscherm, of reserveerde Ollama als marge. Past het model er niet helemaal in, dan gaat een deel naar het werkgeheugen en rekent de processor dat deel uit. Dat is altijd de traagste schakel.
Een MacBook met Apple Silicon. Processor en grafische chip delen hier één geheugen. Een MacBook Air met 16 GB kan dus een groot deel van die 16 GB als videogeheugen gebruiken, en Ollama gebruikt die grafische chip vanzelf. Sinds eind 2024 hebben alle nieuwe MacBook Airs minstens 16 GB. Daarom zijn ze voor dit soort modellen een goede middenweg.
Hoe snel is een lokaal model? Zelf gemeten
Een taalmodel schrijft in tokens: een woord of een stuk van een woord. Ik liet elk model dezelfde opdracht uitvoeren, een PHP-functie die een Nederlands telefoonnummer controleert, en mat hoeveel tokens per seconde het schreef.
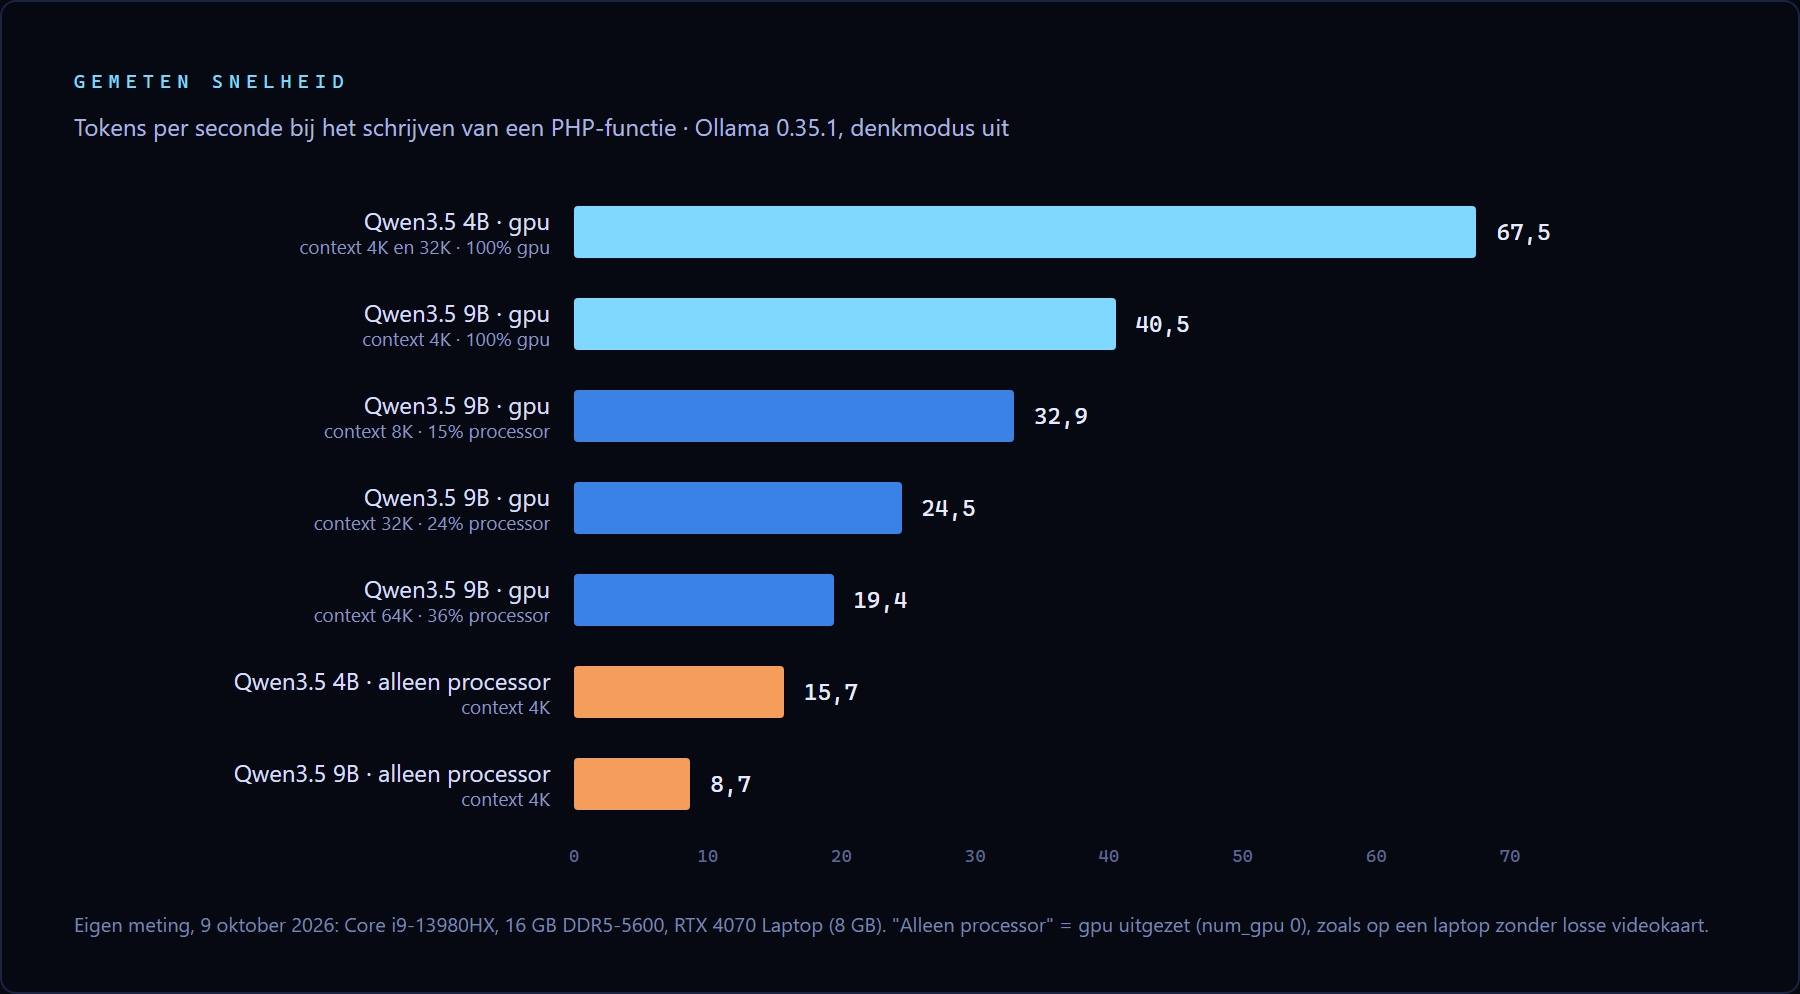
Wat die getallen in de praktijk betekenen, als rekenvoorbeeld: een antwoord van 500 tokens, ongeveer een flinke alinea met een stuk code, staat er bij 40 tokens per seconde in 12 seconden. Bij 15,7 tokens per seconde (4B zonder videokaart) duurt het 32 seconden. Bij 8,7 (9B zonder videokaart) bijna een minuut.
Op een laptop zonder videokaart is er nog een tweede wachttijd: het model moet eerst je vraag inlezen. Zonder gpu las Qwen3.5 9B 62 tokens per seconde, met de gpu 614. Plak je een document van 3.000 tokens, ongeveer vier A4'tjes, dan wacht je zonder videokaart zo'n 48 seconden voordat het eerste woord verschijnt. Met de gpu is dat 5 seconden.
Waarom de snelheid van het geheugen het tempo bepaalt
Hier zit het detail dat de meeste lijstjes overslaan. Voor elk nieuw token leest het model al zijn gewichten één keer uit het geheugen. Bij een model van 6 GB is dat 6 GB per token. Het tempo wordt dus vooral bepaald door hoe snel je geheugen gegevens kan leveren, en veel minder door hoe snel je processor is.
Rekenvoorbeeld voor mijn laptop: twee geheugenmodules DDR5-5600 leveren samen maximaal 89,6 GB per seconde. Gedeeld door de 6,2 GB die het 9B-model zonder gpu in het geheugen innam, geeft dat een bovengrens van ongeveer 14 tokens per seconde. Ik mat 8,7, ongeveer 60 procent daarvan. Het videogeheugen van de RTX 4070 Laptop haalt 256 GB per seconde. Gedeeld door 5,6 GB is dat een bovengrens van 46 tokens per seconde, en ik mat 40,5.
Daarmee kun je de snelheid voor je eigen laptop schatten. Dunne laptops met Intel Core Ultra 200V of Snapdragon X hebben LPDDR5X-geheugen dat rond de 135 GB per seconde haalt, sneller dan de losse modules in mijn laptop. Een MacBook Air met M4 haalt 120 GB per seconde. Voor Qwen3.5 9B komt de bovengrens dan op ongeveer 19 tokens per seconde, en in de praktijk ligt de snelheid daar een stuk onder. Dat is een rekenvoorbeeld, geen meting.
De denkmodus: hetzelfde antwoord, 27 keer zo lang wachten
Terug naar de vraag uit het begin. Qwen3.5 is een redeneermodel: standaard schrijft het eerst een gedachtegang uit voordat het antwoordt. Bij de vraag over 1 maart en 1 juni schreef Qwen3.5 9B 2.992 tokens aan overwegingen, en dat kostte 94 seconden. Met de denkmodus uit gaf het hetzelfde, juiste antwoord in 3,5 seconden. Op "Wat is 2+2?" dacht het 4B-model 863 tokens lang na voordat het "4" zei.
Nadenken helpt bij rekensommen met valkuilen, logische puzzels en lastige programmeerfouten. Voor samenvatten, herschrijven, vertalen of uitleg is het vooral wachten. Op een laptop zonder videokaart, met 9 tokens per seconde, duren die 3.000 tokens denkwerk meer dan vijf minuten.
Uitzetten doe je zo:
ollama run qwen3.5:9b --think=falseWil je weten hoe snel het model op jouw laptop is, zet er dan --verbose achter. Na elk antwoord toont Ollama dan onder meer de "eval rate": het aantal tokens per seconde.
Het contextvenster: waarom 256K op papier 4K op je laptop wordt
Het contextvenster is wat het model tegelijk kan overzien: je vraag, het document dat je plakt en het gesprek tot nu toe, gemeten in tokens. Op de pagina van Qwen3.5 staat bij elke versie 256K, ruim 256.000 tokens, genoeg voor een boek.
Op een laptop krijg je daar standaard 4.096 van. Ollama kiest het venster op basis van het videogeheugen: onder de 24 GB is dat 4K, tussen 24 en 48 GB 32K, en pas vanaf 48 GB de volle 256K. Dat is een verstandige keuze, want elk extra token in het venster kost geheugen. Wordt het gesprek langer dan het venster, dan valt het begin weg. Het model "vergeet" dan wat je in het eerste bericht zei, zonder dat je een melding krijgt.
Mijn metingen laten zien wat een groter venster kost op een gpu van 8 GB. Bij 4K paste Qwen3.5 9B helemaal in het videogeheugen, met 40,5 tokens per seconde. Bij 8K ging 15 procent naar de processor en zakte het tempo naar 32,9. Bij 32K was het 24,5, bij 64K 19,4. Het 4B-model bleef bij 32K volledig op de gpu en liep even snel als bij 4K: 67,9 tokens per seconde. Wie lange documenten wil laten lezen op een gpu van 8 GB, is met het kleinere model en een groot venster dus beter af dan met het grotere model en een klein venster.
Het venster vergroten kan in een lopend gesprek:
/set parameter num_ctx 16384Daarna laat ollama ps in een tweede venster zien hoe het model geladen is:
NAME          ID              SIZE      PROCESSOR          CONTEXT    UNTIL
qwen3.5:9b    56671c2ab938    7.3 GB    24%/76% CPU/GPU    32768      4 minutes from now
Staat er onder PROCESSOR 100% GPU, dan zit alles in het videogeheugen. Een verdeling zoals 24%/76% CPU/GPU betekent dat een deel op de processor draait, en dat kost snelheid. Op een laptop zonder videokaart staat er 100% CPU. Dat is daar normaal.
Eén kanttekening voor wie verder wil. Ollama schrijft in de eigen documentatie dat programmeertools en agents minstens 64.000 tokens context nodig hebben. Een AI-assistent die zelfstandig door je projectbestanden werkt, lukt op een laptop met 16 GB dus wel, maar traag. Voor losse vragen over code werkt het goed.
De modellen die ertoe doen in oktober 2026
Qwen3.5 9B en 4B: de beste allrounders voor 16 GB
Alibaba bracht de kleine Qwen3.5-modellen op 2 maart 2026 uit: 0,8B, 2B, 4B en 9B, onder de Apache 2.0-licentie. Ze lezen tekst en afbeeldingen, kunnen tools aanroepen en ondersteunen volgens Alibaba 201 talen en dialecten. Volgens de modelkaart haalt de 9B-versie op LiveCodeBench v6, een programmeertest, 65,6 punten. Qwen3-30B-A3B-Thinking, een ruim drie keer zo groot model uit 2025, haalt 66,0. De 4B haalt 55,8.
Nieuwere Qwen-generaties zijn er wel. Qwen3.6 en Qwen3.8 kwamen in 2026 uit, maar hun kleinste open versies beginnen voor zover ik kon vinden bij 27 miljard parameters. Voor een laptop met 16 GB blijft Qwen3.5 de nieuwste generatie die past.
Gemma 4 van Google: goed alternatief, maar groter dan de naam doet vermoeden
Google bracht Gemma 4 op 31 maart 2026 uit, met op 3 juni een 12B-versie erbij. De kleine varianten heten E2B en E4B. De E staat voor "effectieve" parameters: het bestand is groter dan het getal suggereert. Gemma 4 E4B is in Ollama 6,6 GB, net zo groot als Qwen3.5 9B. De 12B is 8,0 GB, of 7,2 GB in de QAT-versie (gemma4:12b-it-qat), die is getraind om met 4 bits om te gaan.
Op een MacBook met 16 GB of een laptop zonder videokaart kun je Gemma 4 12B gerust proberen. Op een gpu van 8 GB past het niet in zijn geheel, en dan geldt wat hierboven over de snelheid staat. Wie twee modellen naast elkaar wil zetten, kan het best Qwen3.5 9B en Gemma 4 12B nemen.
Qwen2.5-Coder 7B: nog vaak aangeraden, maar van november 2024
Vraag een chatbot welk lokaal model goed is voor programmeren, en Qwen2.5-Coder 7B komt vaak terug. Het is een prima model van 4,7 GB, maar het is bijna twee jaar oud, leest alleen tekst en heeft in Ollama een venster van 32K. Programmeer je veel, zet het dan naast Qwen3.5 9B en geef ze allebei dezelfde opdracht uit je eigen werk. Het oordeel van dertig minuten zelf proberen is meer waard dan een lijstje.
Te groot voor 16 GB: de mixture-of-expertsmodellen
Je komt modellen tegen als Qwen3.5 35B-A3B en Gemma 4 26B-A4B. Het getal na de A is het aantal parameters dat per token actief is: 3 of 4 miljard. Zulke mixture-of-expertsmodellen rekenen daardoor ongeveer zo snel als een klein model. Maar alle parameters moeten in het geheugen staan, en de bestanden zijn 22 en 18 GB. Op een laptop met 16 GB werkgeheugen past dat niet. Met 32 GB worden dit de interessantste modellen om te proberen.
Installeren: van niets naar een eerste antwoord
- Download Ollama van ollama.com/download. Het werkt op Windows, macOS en Linux en is gratis.
- Open PowerShell (Windows) of Terminal (Mac) en typ
ollama run qwen3.5:4b --think=false. Het model wordt de eerste keer gedownload: 3,3 GB, of 6,6 GB voor de 9B. - Typ je vraag achter
>>>en druk op Enter. Met/byestop je. - Kijk met
ollama psin een tweede venster hoe het model geladen is. - Ruim op als je wilt:
ollama listtoont wat je hebt gedownload, enollama rm qwen3.5:4bverwijdert een model. Op Windows staan de modellen inC:\Users\jouwnaam\.ollama\models.
Liever geen commandoregel? Ollama heeft ook een eigen venster om in te chatten. Je kunt ook LM Studio gebruiken, een programma met een volledige grafische interface waarin je modellen zoekt, downloadt en instelt. LM Studio is sinds juli 2025 ook voor gebruik op het werk gratis. Op Windows vraagt het een processor met AVX2, op de Mac een Apple-chip.
Wat je ermee kunt: vijf opdrachten om mee te beginnen
Een tekst samenvatten die je niet in een clouddienst wilt plakken. Een contract, medische uitslag of personeelsdossier blijft op je eigen laptop. Begin met een korte tekst: in het standaardvenster van 4K tokens passen een paar A4'tjes, inclusief het antwoord.
Vat deze e-mail samen in drie punten en zet erbij wat ik moet doen: [plak de tekst]Een afbeelding laten beschrijven. Qwen3.5 leest afbeeldingen. Zet het pad naar het bestand in je vraag. Ik liet het 4B-model de geheugengrafiek uit dit artikel beschrijven. Binnen 14 seconden, inclusief het laden van het model, schreef het dat de twee grootste modellen "buiten bereik" vallen van een laptop met 16 GB. Dat klopt.
Beschrijf in twee zinnen wat deze grafiek laat zien. ./grafiek.pngCode laten uitleggen. Plak een functie die je niet begrijpt en vraag wat die doet, regel voor regel. Voor uitleg en kleine aanpassingen zijn deze modellen goed. Voor wijzigingen die over een heel project gaan, schieten ze tekort.
Herschrijven en vertalen zonder internet. Een zakelijke mail vriendelijker maken, een tekst naar het Engels zetten, een Excel-formule laten uitleggen. Dit soort korte taken gaat ook zonder videokaart in een halve minuut.
Het model aanroepen vanuit je eigen code. Ollama draait een kleine webserver op je laptop, op poort 11434. Elk programma kan die aanroepen. Dit PHP-voorbeeld heb ik getest:
<?php
$vraag = [
    'model'  => 'qwen3.5:4b',
    'prompt' => 'Vat in één zin samen: de vergadering van dinsdag is verplaatst naar donderdag 14.00 uur, zaal 3.',
    'stream' => false,
    'think'  => false,
];

$context = stream_context_create(['http' => [
    'method'  => 'POST',
    'header'  => 'Content-Type: application/json',
    'content' => json_encode($vraag),
]]);

$antwoord = json_decode(file_get_contents('http://localhost:11434/api/generate', false, $context), true);
echo $antwoord['response'];
Het antwoord was: "De vergadering die aanvankelijk gepland was voor dinsdag, wordt nu om 14.00 uur gehouden in zaal 3 op donderdag." Correct, en een beetje stijf. Dat is een eerlijk beeld van een model van 4 miljard parameters.
Wat je van een lokaal model niet moet verwachten
Een model van 9 miljard parameters is geen Claude, GPT of Gemini. Van de meeste cloudmodellen is de omvang geheim, maar Mistral Large 4 heeft een biljoen parameters: ruim honderd keer zoveel. Het verschil merk je vooral bij lange redeneringen, bij feitenkennis en bij grote programmeertaken. Een lokaal model weet ook niets van wat er na zijn training is gebeurd en kan niet zoeken op internet. Vraag je naar recent nieuws of naar precieze feiten, dan kan het met overtuiging iets verzinnen. Gebruik het voor werk waarbij je het resultaat zelf kunt controleren: samenvatten, herschrijven, uitleggen, eerste versies.
Problemen die je tegenkomt, en de oplossing
| Wat je ziet | Waarschijnlijke oorzaak | Wat je doet |
|---|---|---|
| Het antwoord laat lang op zich wachten, en daarna komt het snel | de denkmodus staat aan | start met --think=false |
| Alles is traag, ook als het model eenmaal schrijft | het model draait deels op de processor | controleer met ollama ps; kies een kleiner venster of een kleiner model |
| De hele laptop hapert | het werkgeheugen is vol en Windows gebruikt de schijf | sluit de browser, of neem het 4B-model |
| Het model vergeet wat je eerder zei | het gesprek is groter dan het contextvenster | vergroot het venster met /set parameter num_ctx of begin een nieuw gesprek |
| De accu is snel leeg | het model gebruikt processor en gpu volop | werk met de lader aangesloten |
Waar je vandaag mee begint
Installeer Ollama, typ ollama run qwen3.5:4b --think=false en stel de vraag die je nooit in een cloudchatbot zou plakken. Werkt dat naar je zin en heb je een videokaart of een MacBook, probeer dan de 9B. Lees bij twijfel ollama ps.
Eén ding is me bij het meten het meest opgevallen. De keuze voor een model maakte minder verschil dan de twee instellingen die bijna niemand aanpast. Met de denkmodus aan wachtte ik 94 seconden op een antwoord dat ook in 3,5 seconden kon. En een venster van 32K maakte hetzelfde model 40 procent trager. Op een gewone laptop bepaalt niet het slimste model of je het blijft gebruiken, maar het model dat je goed instelt.
Bronnen
- Ollama, Qwen3.5-versies en bestandsgroottes, Gemma 4-versies en Qwen2.5-Coder-versies (geraadpleegd 9 oktober 2026)
- Ollama, Context length: standaardvenster per hoeveelheid videogeheugen en de 64.000 tokens voor programmeertools
- Ollama, FAQ (num_ctx, opslaglocatie, privacy) en Cloud models
- Qwen, modelkaart Qwen3.5-9B: architectuur, licentie en LiveCodeBench-scores
- Google, Gemma releases: data van Gemma 4 en Gemma 4 12B
- LM Studio, LM Studio is free for use at work (8 juli 2025) en systeemeisen
- Nvidia, GeForce RTX 40-laptops: 8 GB GDDR6 voor de RTX 4070 Laptop
- Eigen metingen, 9 oktober 2026: Ollama 0.35.1, Core i9-13980HX, 16 GB DDR5-5600, RTX 4070 Laptop


