Mistral Large 4: een biljoen parameters uit Europa, en wat "open" hier nog niet betekent
Mistral Large 4 is het eerste Europese open-weightmodel van een biljoen parameters. Wat de cijfers van Mistral wel en niet zeggen, wat het kost, welke hardware je nodig hebt en waarom de licentie de belangrijkste open vraag is.

Wie Mistral Large 4 op een eigen server wil draaien, heeft bij 4-bit-precisie ongeveer 525 gigabyte geheugen nodig. Alleen voor de gewichten. Dat is het geheugen van zeventien RTX 5090's. Toch is dit het model waar Europa op wachtte: het eerste Europese open-weightmodel van een biljoen parameters, getraind in Europese datacenters en op 6 oktober 2026 als preview gelanceerd.
Mistral noemt het intern ML4, en "very officially: le Chonk". De aankondiging staat vol grafieken waarin het model wint. Wie verder leest dan de koppen, vindt een bescheidener en interessanter verhaal. Large 4 is niet het beste model ter wereld, en Mistral beweert dat ook niet. Het is wel het sterkste model dat je straks buiten China kunt downloaden. Voor organisaties die hun gegevens niet bij een Amerikaanse of Chinese aanbieder willen onderbrengen, verandert dat de keuze.
Feiten gecontroleerd op 9 oktober 2026. Large 4 is een preview: de cijfers komen van Mistral of van de genoemde media en kunnen voor de definitieve versie nog veranderen. Ik heb het model voor dit artikel niet zelf getest. Rekenvoorbeelden staan als rekenvoorbeeld aangegeven.
Wat is Mistral Large 4?
Mistral Large 4 is een taalmodel van het Franse Mistral AI met ongeveer een biljoen parameters, waarvan er per token 52 miljard meedoen. Het leest tekst en afbeeldingen, schrijft tekst, kan direct antwoorden of eerst stap voor stap redeneren, en heeft een contextvenster van een miljoen tokens. Sinds 6 oktober is het als preview te gebruiken via de API van Mistral Studio. De gewichten volgen volgens Mistral "by the end of the month", volgens Tweakers en VentureBeat op 27 oktober.
| Mistral Large 4 | Preview, 6 oktober 2026 |
|---|---|
| Parameters | 1,05 biljoen volgens de modelkaart; Mistral rondt af op 1 biljoen |
| Actief per token | 52 miljard (eerste berichten noemden 49 miljard) |
| Opbouw | mixture-of-experts, met een beeldencoder van 1,6 miljard parameters |
| Invoer en uitvoer | tekst en beeld erin, tekst eruit |
| Contextvenster | 1 miljoen tokens |
| Talen | meer dan 160, waaronder alle officiële EU-talen |
| Training | 3.800 Nvidia Grace Blackwell-gpu's in Europese datacenters |
| Prijs API | $1,36 per miljoen tokens invoer, $4,18 per miljoen uitvoer; tijdens de introductie de helft |
| Gewichten | eind oktober; licentie nog niet gepubliceerd |
Dat bronnen elkaar tegenspreken (49 of 52 miljard actief, 3.800 of "ongeveer 4.000" gpu's) zegt vooral iets over de status van het model: Mistral is nog aan het trainen. De reinforcement-learningrun loopt nog en het model vertoont volgens Mistral "no signs of saturation". De architectuur en de trainingsmethode publiceert het bedrijf pas samen met de gewichten.
Een biljoen parameters, maar rekenen als een model van 52 miljard
Large 4 is een mixture-of-experts-model. Het netwerk bestaat uit veel deelnetwerken, de experts, en per token kiest een router er een handvol uit. Per woord rekent het model daardoor ongeveer zoveel als een gewoon model van 52 miljard parameters, terwijl het de kennis van een biljoen parameters meedraagt. Dat verklaart waarom een model van deze omvang voor $4,18 per miljoen uitvoertokens te verkopen is.
In veel berichten valt het gevolg weg: snel rekenen is iets anders dan klein zijn. Alle experts moeten in het geheugen staan, ook de experts die bij jouw vraag niets doen, want de router kiest pas per token welke hij nodig heeft.
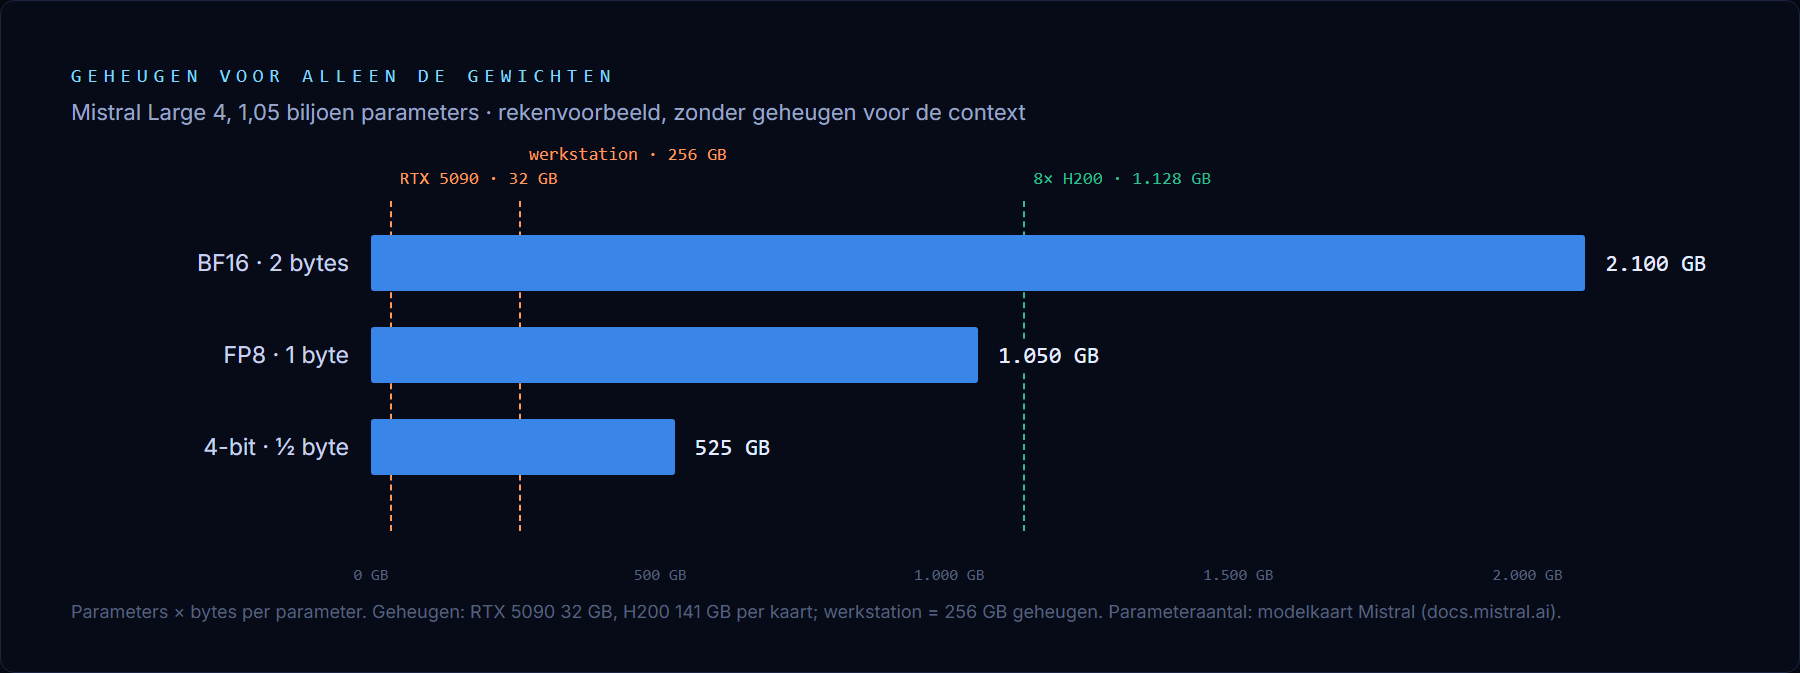
Het rekenvoorbeeld: 1,05 biljoen parameters keer 2 bytes in BF16 is 2,1 terabyte. In FP8 (1 byte per parameter) is het 1,05 terabyte, in 4-bit 525 gigabyte. Daar komt geheugen voor de context nog bij, en wie het venster van een miljoen tokens echt vult, heeft er flink meer nodig. Een RTX 5090 heeft 32 gigabyte. Een server met acht Nvidia H200's heeft er 1.128, genoeg voor de FP8-versie met een kleine marge.
Ter vergelijking: Mistral Large 3, uitgebracht in december 2025, had 675 miljard parameters, waarvan 41 miljard actief. Large 4 is ruim anderhalf keer zo groot en doet per token maar een kwart meer rekenwerk.
"Open" betekent bij dit model dus: open voor organisaties met een serverrack en voor hostingpartijen die het model aanbieden. Niet voor je laptop. Onder het bericht op Tweakers ging een groot deel van de reacties precies daarover: de populaire open modellen draaien op een machine met 128 of 256 gigabyte geheugen, deze niet.
De licentie van Large 4 is nog onbekend
Mistral Large 3 kwam uit onder Apache 2.0. Daarmee mag je het model commercieel gebruiken, aanpassen en voor anderen hosten, zonder iets te vragen. Voor Large 4 heeft Mistral nog geen licentie gepubliceerd. VentureBeat meldt dat de gewichten onder een eigen Mistral-licentie komen; Tweakers schrijft dat niet duidelijk is welke.
Het verschil doet ertoe. Mistral noemt Large 4 zelf "open-weight", geen open source. In een eigen licentie kan een bedrijf van alles vastleggen, zoals een omzetgrens voor gratis commercieel gebruik, een verbod op het aanbieden als dienst aan derden of voorwaarden voor afgeleide modellen. Wat er in deze licentie staat, weet buiten Mistral niemand. Wie nu een architectuur ontwerpt waarin Large 4 op eigen servers draait, bouwt op een document dat nog niet bestaat.
Hoe goed is Mistral Large 4? De eigen cijfers zijn eerlijker dan de koppen
De koppen zeggen: het sterkste open model buiten China. De grafieken van Mistral zelf laten zien wat dat betekent.
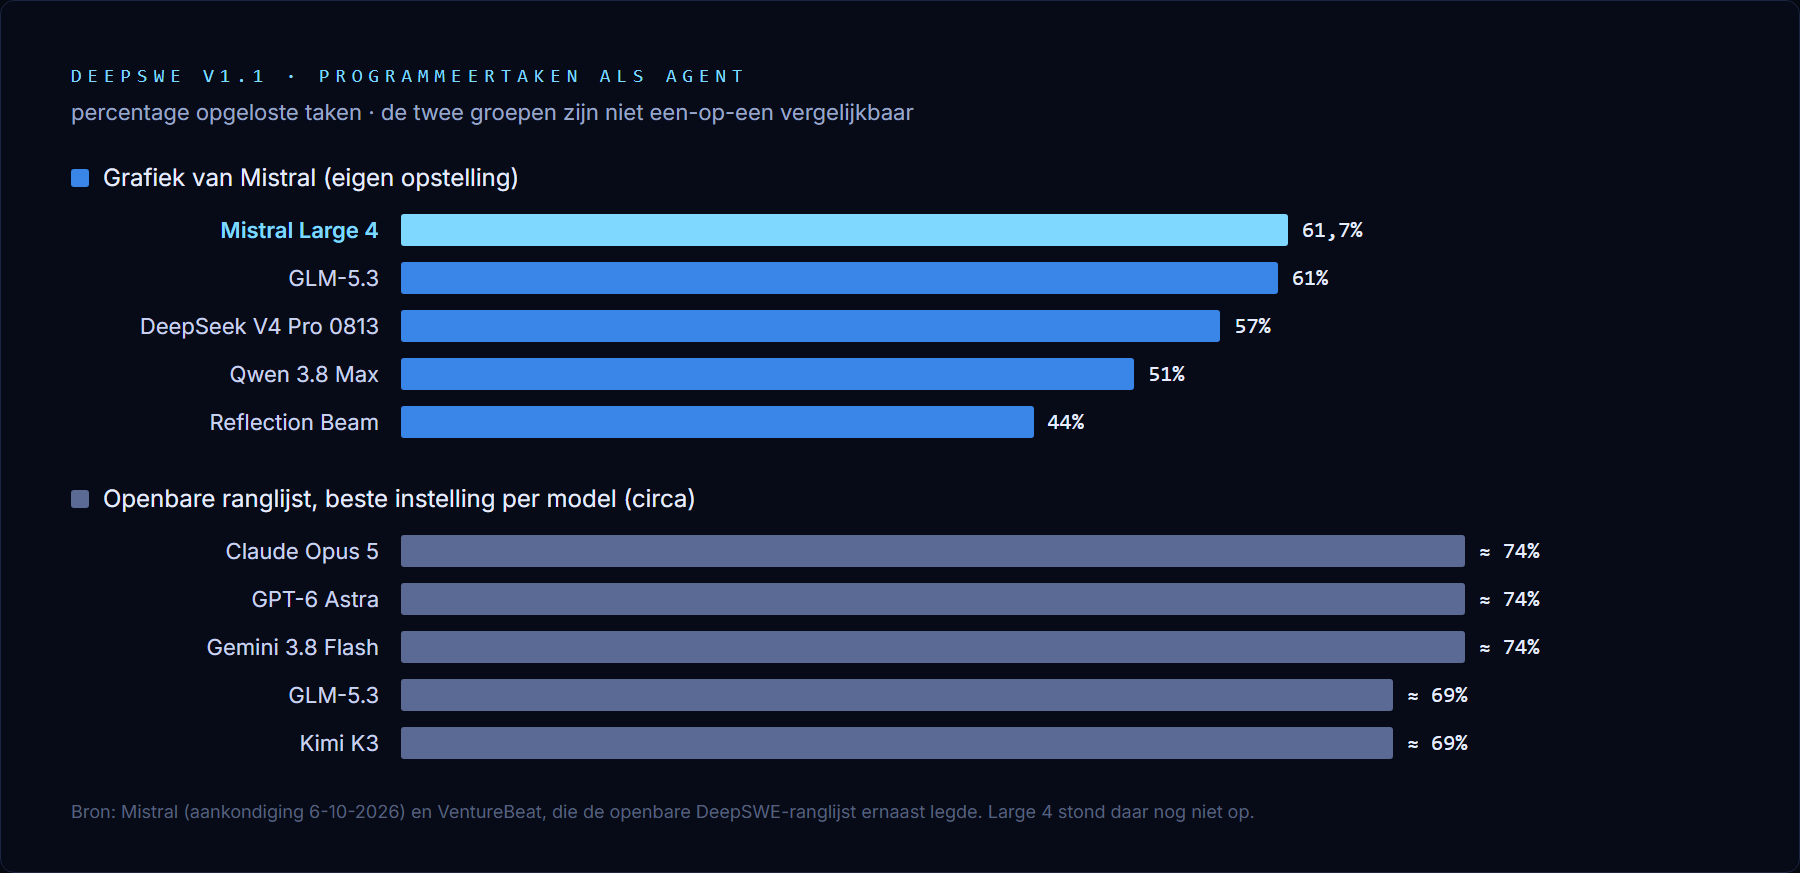
Op DeepSWE v1.1, een test waarin een model als agent echte programmeertaken oplost, haalt Large 4 in de grafiek van Mistral 61,7 procent. Dat is net boven GLM-5.3 (61) en ruim boven DeepSeek V4 Pro (57) en Qwen 3.8 Max (51). VentureBeat legde daar de openbare DeepSWE-ranglijst naast. Met hun beste instellingen halen Claude Opus 5, GPT-6 Astra en Gemini 3.8 Flash daar ongeveer 74 procent, GLM-5.3 en Kimi K3 ongeveer 69. De opstellingen verschillen, dus de getallen zijn niet een-op-een te vergelijken. Het gat met de gesloten top is wel groter dan de grafiek van Mistral doet vermoeden.
Bij een blinde test van Surge AI gaven beoordelaars code van vijf modellen een cijfer van 1 tot 5. Large 4 kreeg een 3,74: tweede van de vijf, achter Claude Opus 5 met 4,22. Ook dat cijfer publiceert Mistral zelf, en dat pleit voor het bedrijf. Het verstopt niet dat Anthropic's model beter programmeert.
Sterker is Large 4 buiten het programmeren. Op de juridische agenttest van Harvey haalt het 15 procent, tegen 13 voor Kimi K3 en 5 voor GPT-6 Astra, al staan op de ranglijst van Vals meerdere gesloten modellen hoger. Op DIOR-RSVG, waarin een model objecten in satelliet- en luchtfoto's moet aanwijzen, scoort het 73 procent tegen 68 voor GPT-6 Astra. Dat Mistral juist die test uitlicht, past bij de klanten die het voor ogen heeft: VentureBeat noemt luchtbeelden, technische tekeningen en chipontwerp als doelgebieden.
Cybersecurity: sterk op een test die anderen weigeren
Het opvallendste cijfer in de aankondiging gaat over beveiliging. Bij een test waarin een model een kwetsbaarheid moet nabouwen en daarna repareren, scoort Large 4 volgens Mistral 82 procent. Claude Opus 5.5 en GPT-6 Astra scoren op dezelfde test "near zero", schrijft Mistral, omdat ze de opdracht weigeren.
Die nul meet dus wat de makers hun model laten doen, niet wat het kan. Mistral maakt van dat verschil een verkoopargument. Het bedrijf test Large 4 drie weken met beveiligingsbedrijven, geselecteerde partners en overheidsdiensten, die volgens de aankondiging "the same model with reduced moderation and expanded cyber capabilities" krijgen. Volgens medeoprichter Guillaume Lample, geciteerd door TNW, moeten bedrijven en overheden zich daarmee kunnen verdedigen tegen aanvallers.
Tegelijk claimt Mistral dat de publieke versie op drie jailbreaktests (JailbreakBench, StrongREJECT en AgentHarm) vaker weigert dan elk ander geteste open model. Die claims hoeven niet te botsen: een bekend lek nabouwen en dichten is iets anders dan een aanval uitvoeren. Ze laten wel zien waar de keuze verschuift. Bij de grote Amerikaanse modellen trekt de aanbieder voor iedereen dezelfde grens. Bij Large 4 beslist Mistral wie een ruimere grens krijgt. En zodra de gewichten openbaar zijn, kan iedereen die ze downloadt die grens met eigen training verleggen.
Wat Mistral Large 4 kost
Via de API kost Large 4 $1,36 per miljoen invoertokens en $4,18 per miljoen uitvoertokens. Tijdens de introductie rekent Mistral de helft: $0,68 en $2,09. Invoer die al in de cache staat, kost $0,14 per miljoen tokens, in de aanbieding $0,07.
Rekenvoorbeeld tegen de normale prijs: je zet een codebase of dossier van een miljoen tokens in het contextvenster en krijgt een antwoord van 50.000 tokens terug. Dat kost $1,36 plus $0,21, samen $1,57. Stel je daarna tien vervolgvragen over hetzelfde materiaal, dan bepaalt de cache de rekening. Komt de invoer uit de cache, dan kosten tien keer een miljoen tokens $1,40. Zonder cache is dat $13,60. Wie met lange documenten werkt, moet dus eerst uitzoeken wanneer de cache van Mistral wel en niet geraakt wordt.
Voor wie Large 4 wel verschil maakt
Een Europese organisatie die een topmodel op eigen servers wilde draaien, had tot nu toe vooral Chinese keuzes: DeepSeek, GLM, Kimi, Qwen. De meeste open-weightmodellen komen uit China, schrijft Tweakers, en DeepSeek heeft zelfs grotere. Technisch maakt de herkomst weinig uit: een model op je eigen server stuurt geen gegevens naar Peking. Dat argument kwam in de reacties op Tweakers steeds terug, en het klopt.
Wat het argument mist, is alles rond het model: wie het trainde, op welke data, onder welk recht, en wie je belt als er iets misgaat. Volgens TNW willen de klanten van Mistral twee garanties: dat geen buitenlandse overheid hun toegang kan afsluiten, en een duidelijk verslag van hoe het model getraind is. Mistral biedt Large 4 daarom aan via de API in een gekozen regio, waaronder een Europese omgeving die het bedrijf naar eigen zeggen "end-to-end" zelf beheert, in een private cloud of op eigen servers. Het bedrijf werkt volgens TNW voor ruim 125 grote bedrijven, onder wie Airbus, ASML en HSBC.
Voor een ziekenhuis, een gemeente, een defensieleverancier of een bank is dat de nieuwe optie: een model dat in de buurt van de top komt, met een Europese leverancier en een eigen kopie. Voor een ontwikkelaar die gewoon een goed model via een API zoekt, is Large 4 een van de vele, en voor programmeerwerk niet de sterkste.
Het geld om die positie vast te houden is er. In september haalde Mistral €3 miljard op bij een waardering van ruim €21 miljard, volgens het bedrijf de grootste aandelenronde ooit van een Europees techbedrijf. Large 4 is het eerste model uit die ronde. De extra rekenkracht komt volgens TNW in de eerste helft van 2027 beschikbaar.
Wat je nu met Mistral Large 4 kunt doen
Test het deze maand op je eigen werk. De API kost tijdens de introductie de helft, en twintig echte taken uit je eigen praktijk zeggen meer dan een grafiek van de maker. Leg de antwoorden naast die van het model dat je nu gebruikt, en noteer waar het verschil zit.
Plan pas iets op eigen servers als eind oktober drie dingen bekend zijn: de licentietekst, de grootte van het checkpoint en welke kleinere of gequantiseerde versies Mistral meelevert. Dan belooft Mistral ook de architectuur en de trainingsmethode te publiceren.
De vraag die Large 4 beantwoordt, is niet of Europa het beste model ter wereld kan bouwen. Dat lukt nog niet, en de grafieken van Mistral zelf laten dat zien. De vraag is of een Europese organisatie een model dicht bij de top kan bezitten in plaats van huren. Eind oktober horen we onder welke voorwaarden.
Bronnen
- Mistral AI, Mistral Large 4 (aankondiging, 6 oktober 2026)
- Mistral AI, modelkaart Mistral Large 4: parameters, contextvenster en prijzen (geraadpleegd 9 oktober 2026)
- Tweakers, Europese Mistral brengt openweightmodel Large 4 met biljoen parameters uit (6 oktober 2026), met de reacties eronder
- VentureBeat, Mistral debuts Large 4 'Le Chonk': licentie, vergelijking met Large 3 en met de openbare DeepSWE-ranglijst
- The Next Web, Europe's Mistral launches Large 4 to challenge China's lead in open AI models: training, klanten en citaten
- Orrick, Mistral's €3B Series D at €21B post-money valuation (september 2026)


